LLM Bento · 一張討論用的地圖
這個論點住在哪一層?
我們聊 LLM 的時候,常常一次混進好幾個問題。每一個都有它的層次,和它該用的證據。挑一個論點,看它住在哪一層。
或者,從一個層次開始:在上面的圖裡點選一層。
社會 最表層
它改變了什麼?
工作、權力、安全、注意力、意義。這些問題沒有純粹技術性的答案,因為它們也關乎我們想要什麼。證據來自歷史、經濟與政治,最終來自我們看重什麼。
這裡算數的是 歷史、經濟、政治,以及我們看重什麼
 傑佛瑞·辛頓 幫深度學習打下基礎,2023 年離開 Google,為的是警告它會把我們帶到哪裡。
 約書亞·班吉歐 主持《國際 AI 安全報告》,2026 年 9 月向聯合國安理會做簡報。
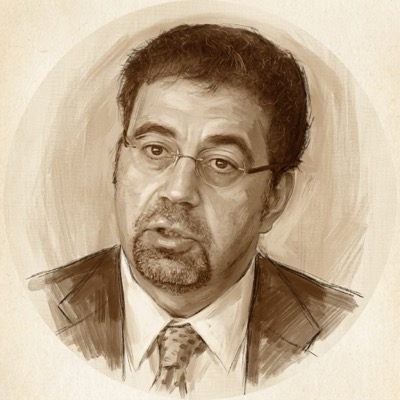 Daron Acemoglu 主張誰能從 AI 拿到好處,是政治的選擇,不是技術的必然。
繼續深入:慢新聞
駕馭 往下一層
它能做什麼?
單靠自己,模型只會回答。替它套上上下文、工具與迴圈,它就能讀檔案、跑程式、搜尋,一直做到任務完成。很多人口中的「模型」,其實是它外面那層駕馭。這裡的問題,是今天什麼真的可靠地行得通。
這裡算數的是 今天行得通的東西:展示、基準測試、實際使用
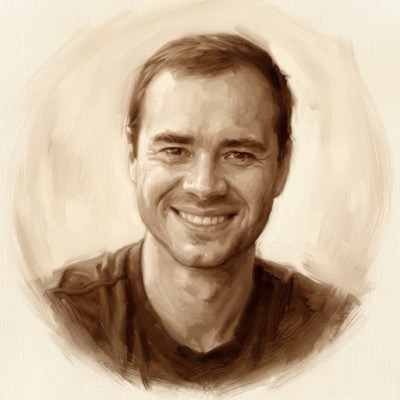 Andrej Karpathy 談程式 agent 與「迴圈時代」:不用你盯著也會一直做下去的模型。
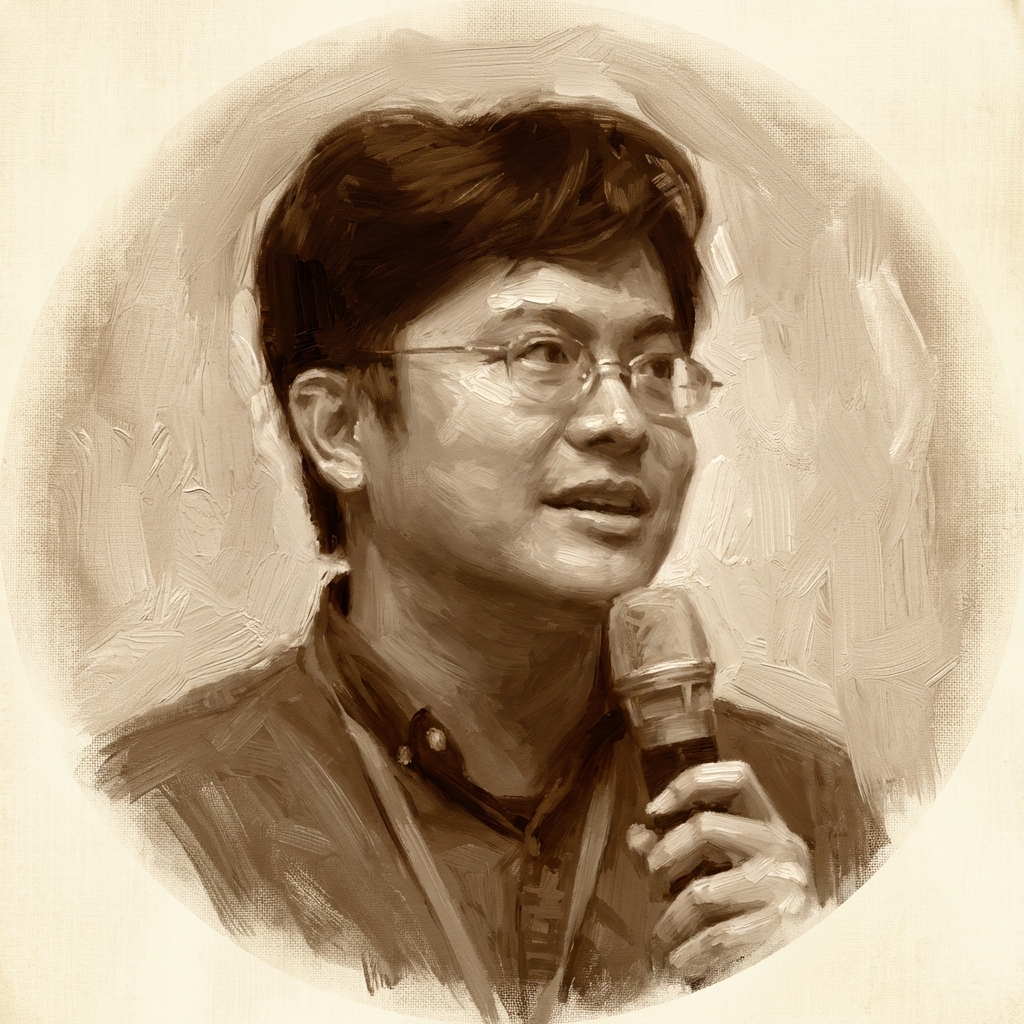 李宏毅 他的課「駕馭工程」:有時候模型已經夠聰明,不夠好的是駕馭。
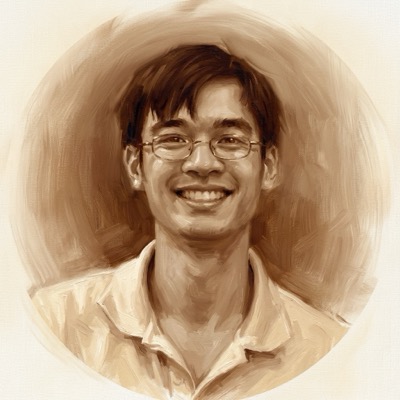 Terence Tao 在程式 agent 的協助下用 Lean 形式化證明,也一再強調判斷仍然是他自己的。
繼續深入:模型之外
後訓練 往下兩層
它被塑造成什麼?
預訓練產出的,是一個會接著寫下去的模型。後訓練決定它變成什麼。獎勵人類的偏好(RLHF),你會得到一個聽起來熱心又篤定的助理;獎勵正確(RLVR),你會得到一個先推理再回答的解題者。一個模型的個性——它怎麼說話、拒絕什麼——也是在這個階段成形的。同一類的根基,不同的用途。
這裡算數的是 實驗室選擇獎勵什麼
 Amanda Askell 一位哲學家,負責 Claude 的個性工作——這份工作引出一個難題:誰的價值觀會變成預設?
 Noam Brown 共同打造 OpenAI o1,也很早就主張讓模型先想久一點再回答。
 Nathan Lambert 寫了 RLHF 的教科書,也在 Ai2 帶領後訓練,做出連訓練資料都公開的模型。
繼續深入:AI 對齊
預訓練 往下三層
它是怎麼學的?
文字變成 token,token 變成向量,注意力讓每個 token 都能看見其他所有 token。在人類寫下的大量文字上訓練它預測下一個 token,Transformer 最後長出了沒有人親手寫進去的結構。這裡的問題,關乎機制與規模。
這裡算數的是 數學與實驗
 Grant Sanderson 把 Transformer 與注意力畫出來,讓你看著它們運作。 Andrej Karpathy 在鏡頭前從零寫出一個 GPT,一行一行來。
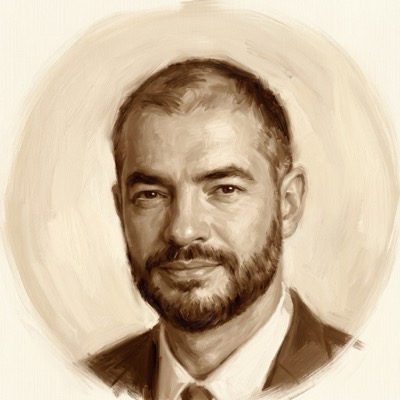 Ilya Sutskever 主導了 GPT 系列背後的研究;如今說,規模擴張的時代正在讓位給研究的時代。
繼續深入:LLM 如何誕生
認知 最深層
它能知道什麼?
LLM 從來沒有碰過這個世界。我們有:我們看見它、在其中移動、在其中犯錯。LLM 知道的一切,都是透過我們而來——透過我們的理解,和我們寫下的東西。它是透過人認識世界的,不是親身經歷。世界模型押的是另一條路:像我們一樣學,直接從世界學,從影像、空間與行動中學。這裡的問題,是任何系統能知道什麼、又是從哪裡知道的。
這裡算數的是 論證與思想實驗
傑佛瑞·辛頓 主張要把下一個字預測得夠好,模型就必須理解產生這些文字的世界。 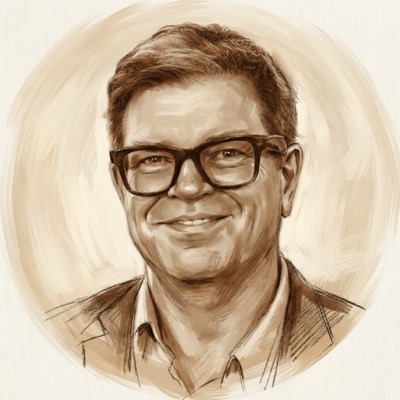 楊立昆 離開 Meta,去打造從物理世界、而不是從文字學習的世界模型。
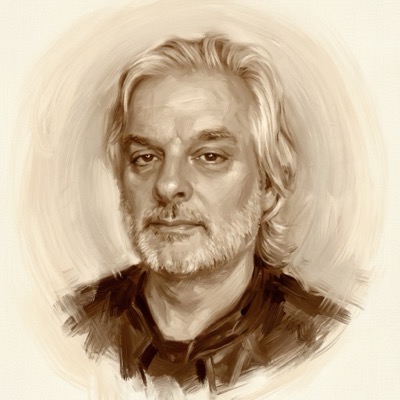 David Chalmers 提出意識的「困難問題」,如今問:我們跟 LLM 說話時,到底是在跟什麼說話?
繼續深入:LLM 真的理解嗎?