關於
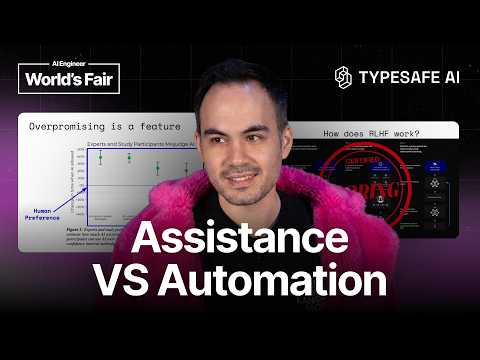
Diogo Almeida 是 TypeSafe AI 的創辦人暨執行長,也是 InstructGPT(2022)的第四作者——那篇 OpenAI 論文讓 RLHF 成為把語言模型變成助理的標準做法。他做過 ChatGPT 與 GPT-4 背後的 post-training,更早之前在 Google Brain。如今他主張,自己參與打造的這項技術,正是自動化卡住的原因。RLHF 最佳化的是人類偏好,而 reward model 要偵測「看得出來的不確定」,遠比查核答案是否正確容易得多——於是這個目標函數獎勵的是聽起來很有把握。照他的說法,hallucination 不是等著被修掉的瑕疵,而是目標函數照規格運作的結果;ChatGPT 之後的助理時代,則是偏離「能真正做事的軟體」的一段「weird detour」。TypeSafe 的答案是 RLCD——為校準決策而做的強化學習——以及一個叫 Jev 的模型:它回傳的是附帶機率的型別化數值,而不是散文。
主要貢獻
- InstructGPT(2022)二十位作者中的第四位,那篇論文讓 RLHF 成為把語言模型變成助理的標準做法
- 在 OpenAI 參與 ChatGPT 與 GPT-4 背後的 post-training,更早之前在 Google Brain
- 主張 RLHF 的偏好目標讓 hallucination 成為內建而非意外:reward model 偵測「看得出來的不確定」,遠比查核正確性容易,於是訓練獎勵的是有把握的語氣
- 依各自最佳化的目標把 post-training 分成三支——RLHF 對準人類偏好,RLVR 對準純粹的正確性,而 TypeSafe 的 RLCD 對準校準過的決策
- 把 ChatGPT 之後的助理時代稱為偏離真正自動化的「weird detour」,並指出 SaaS 自 2019 年以來幾乎沒變,只是旁邊多掛了一個聊天機器人
- 創辦 TypeSafe AI 並在 2026 年 9 月推出 Jev:回傳的是符合事先定義好的 schema 的數值,並附上這間實驗室所謂校準過的機率,而不是自由文字
時刻時間軸 查看所有時刻
影片與訪談
論文與出版物
思想連結
約書亞·班吉歐
思想同道AI 先驅與安全研究者
這是一種共鳴,而非有記載的交往——不過在 Almeida 2026 年的演講上,有位聽眾正好把兩人並置,問他能不能大致照 Bengio 提議的方向做;Almeida 只說這很複雜,便帶過了。Bengio 的 Scientist AI 被設計來解釋世界,「而不是在世界中採取行動,去模仿或討好人類」,並帶著明確的不確定性,以防過度自信的預測;TypeSafe 的後訓練則以 Almeida 所說的「校準過的決策」為目標。兩人都把校準視為擺脫討好人類的出路,動機卻相反:一個為了讓代理安全,一個為了讓自動化值得信任。
arxiv.org · youtube.com
理查·薩頓
思想對照Oak Lab 創辦人、亞伯達大學教授
兩人都認為眼下走錯了路,卻對錯在哪裡看法不同。Sutton 認為語言模型「是在模仿人」,「沒有目標,也沒有好壞之分」,錯就錯在模仿本身;Almeida 則稱預訓練「非常了不起」,只把問題歸到最後一步——針對人類偏好做最佳化。同一場演講裡,他提到 Sutton 的〈苦澀的教訓〉,並加以修正:資料比算力重要,而做對的任務又比資料更重要。
youtube.com · dwarkesh.com
Amanda Askell
曾經合作哲學家暨 AI 對齊研究員
兩人都是 InstructGPT(2022)的作者——這篇出自 OpenAI 對齊團隊的論文,讓「人類回饋強化學習」(RLHF)成為打造助理的標準最後一步;Almeida 是主要作者之一,Askell 則列名於較外圈的作者群。論文借用了 Askell 先前提出的「有幫助、誠實、無害」框架,卻也坦承:面對一個黑箱模型,誠實無從衡量,只能退而衡量真實性。Almeida 後來的論點正是從這道缺口出發:以人類偏好為核心的目標,獎勵「聽起來對」遠比獎勵「有校準的把握」來得容易。
arxiv.org

